
در عصر طلایی هوش مصنوعی، که مدلهای زبان بزرگ (LLMs) با سرعتی باورنکردنی در حال پیشرفت هستند، نیاز به دادههای آموزشی با کیفیت بالا به یک چالش اساسی تبدیل شده است. این نیاز مبرم، شرکتهای فناوری را به سمت منابع غیرمنتظرهای سوق داده است: کتابهای چاپی. اما آنچه این روند را نگرانکننده میکند، نه صرفاً دیجیتالیسازی، بلکه روشهای «اسکن تخریبی» است که به نابودی فیزیکی میلیونها جلد کتاب منجر میشود. این پدیده، ابعاد گستردهای از قحطی داده، پیامدهای اخلاقی، حقوق مالکیت فکری و چالشهای حفظ میراث فرهنگی را در بر میگیرد که در این مقاله به تفصیل به آنها خواهیم پرداخت.
قحطی داده هوش مصنوعی: چرا کتابهای فیزیکی هدف قرار میگیرند؟
مدلهای زبان بزرگ برای دستیابی به تواناییهای پیشرفته خود، نیازمند دسترسی به مجموعههای دادهای عظیم و متنوع هستند. محققان هوش مصنوعی به این نتیجه رسیدهاند که این مدلها تقریباً تمام متون با کیفیت و رایگان موجود در اینترنت را اسکن و پردازش کردهاند و به اصطلاح با «قحطی داده» (Data Scarcity یا Data Wall) مواجه شدهاند. این کمبود داده، شرکتهای فناوری را به سمت منابع جدید و اصیلتر سوق داده است.
در این شرایط، کتابهای چاپی، به ویژه آنهایی که قبل از سال ۲۰۲۲ منتشر شدهاند و هنوز با محتوای تولید شده توسط هوش مصنوعی «آلوده» نشدهاند، به عنوان منبعی استراتژیک و حیاتی برای آموزش مدلهای هوشمندتر شناخته میشوند. این کتابها متونی عمیق، غنی و دستنخورده از خلاقیت انسانی را ارائه میدهند که برای بهبود کیفیت و کاهش سوگیری در LLMها ضروری است. محتوای انسانی اصیل، تنوع زبانی و فکری را تضمین میکند که برای جلوگیری از «مدلهای آینهای» که صرفاً بازتابی از محتوای موجود هستند، حیاتی است.
دادههای مصنوعی: راهکاری با چالشهای خاص
یکی از راهحلهای نویدبخش برای مقابله با قحطی داده، تولید «دادههای مصنوعی» (Synthetic Data) است که توسط کامپیوترها به صورت مصنوعی ایجاد میشوند و الگوهای آماری دادههای واقعی را تقلید میکنند. این روش میتواند به حفاظت از اطلاعات حساس کمک کرده و مدلهای هوش مصنوعی را با دادههای مقیاسپذیر و مطابق با مقررات آموزش دهد. با این حال، دادههای مصنوعی نیز ممکن است خطراتی مانند تولید مدلهای نامطلوب یا سوگیرانه را به همراه داشته باشند، زیرا کیفیت آنها به شدت به کیفیت مدل تولیدکننده و دادههای اولیه بستگی دارد.
نابودی کتاب برای آموزش هوش مصنوعی: روشها و واقعیت تلخ
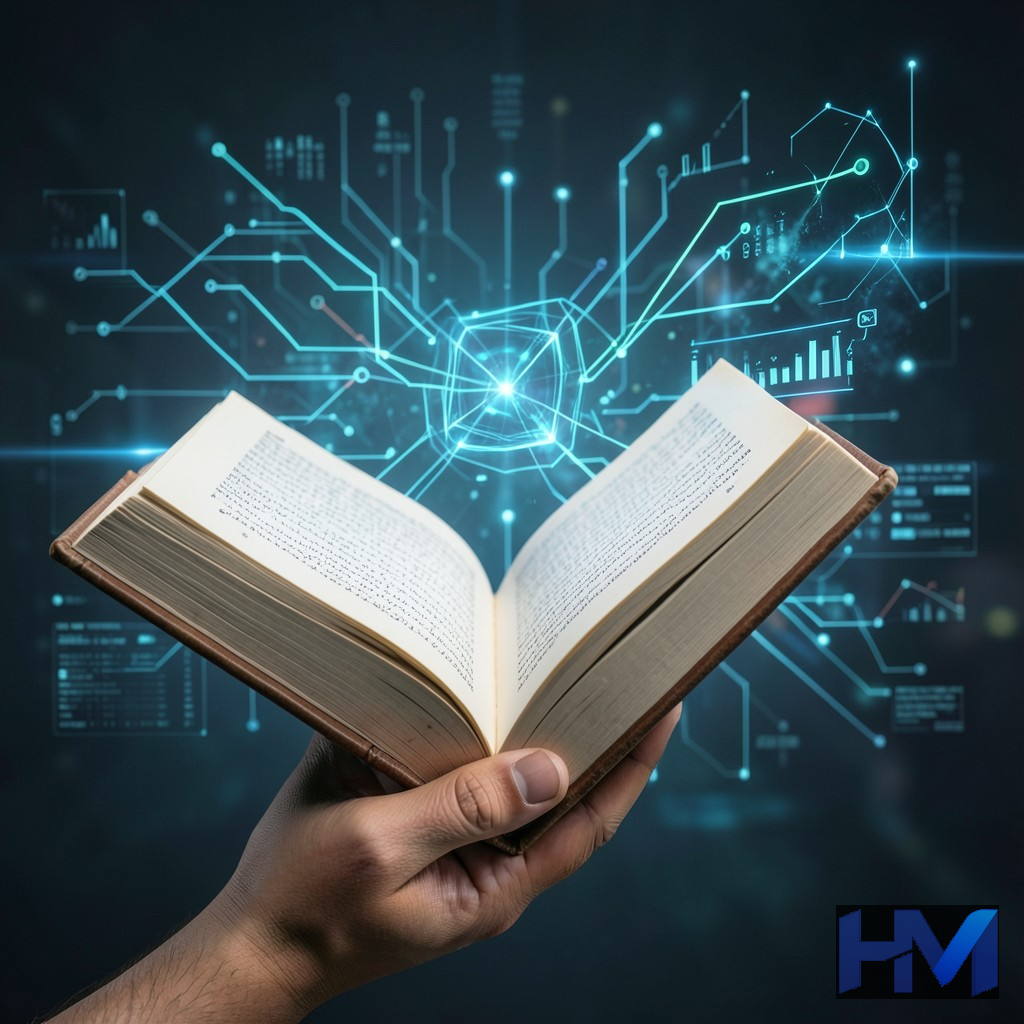
بر اساس گزارشهای افشاگرانه و پروندههای حقوقی، شرکتهای بزرگ هوش مصنوعی مانند Anthropic و Meta برای تسریع فرآیند دیجیتالیسازی و کاهش هزینهها، به خرید میلیونها جلد کتاب چاپی دستدوم روی آوردهاند. در این روش که «اسکن تخریبی» نامیده میشود، شیرازه کتابها با دستگاههای برش هیدرولیک جدا شده و صفحات آنها به صورت مجزا وارد اسکنرهای صنعتی پرسرعت میشوند تا متن دیجیتالی شود. نتیجه این فرآیند، نابودی فیزیکی و کامل میلیونها جلد کتاب است.
این اقدام، خشم نویسندگان، ناشران و فعالان فرهنگی را برانگیخته است، چرا که بسیاری از این کتابها، به ویژه نسخههای کمیاب و تخصصی، ممکن است برای همیشه از بین بروند و دسترسی انسانها و حتی سیستمهای هوش مصنوعی آینده به آنها ناممکن شود. این روش، میراث مکتوب بشریت را به بهای پیشرفت هوش مصنوعی به خطر میاندازد. به عنوان مثال، شرکت Anthropic به دلیل نگهداری آرشیوی شامل ۷ میلیون نسخه کتاب دیجیتالی دزدی که حقوق پدیدآورندگان را نقض میکرد، با پروندههای حقوقی متعددی مواجه شده است که نشاندهنده ابعاد حقوقی و اخلاقی این چالش است.
LLMs و چالشهای دادههای آموزشی: فراتر از حجم
مدلهای زبان بزرگ مانند Claude یا Gemini بر اساس حجم عظیمی از دادههای متنی آموزش میبینند تا الگوهای زبان، ساختارها و معانی را درک کنند. این مدلها با سنتز اطلاعات آموختهشده، متنهای جدید و منحصربهفرد تولید میکنند، نه اینکه صرفاً محتوای آموزشی را کپی کنند. با این حال، کیفیت، تنوع و عدم سوگیری دادههای آموزشی برای عملکرد صحیح و اخلاقی این مدلها حیاتی است. استفاده از دادههای سوگیرانه میتواند منجر به نتایج تبعیضآمیز و کاهش عملکرد مدل در گروههای کمنماینده شود.
چالش اصلی این است که LLMs به دلیل مقیاس عظیم خود، مانند یک «جعبه سیاه» عمل میکنند. دادههای ورودی، فرآیندهای داخلی و خروجیهای آنها باید به دقت مورد بررسی قرار گیرند تا از انتشار اطلاعات نادرست، تعصبات و حتی محتوای مضر جلوگیری شود. این امر مستلزم استانداردهای سختگیرانه برای جمعآوری و پالایش دادهها است.
پیامدهای اخلاقی و حقوقی: مالکیت فکری، حریم خصوصی و "استفاده منصفانه"
استفاده از کتابها و سایر آثار دارای حق کپیرایت برای آموزش هوش مصنوعی، چالشهای پیچیدهای را در حوزه مالکیت فکری ایجاد کرده است. قوانین فعلی مالکیت فکری عموماً «خلق انسانی» را شرط حمایت میدانند، بنابراین تعیین مالکیت آثار تولیدشده توسط هوش مصنوعی مبهم است. در ایالات متحده، اداره کپیرایت ثبت آثار ۱۰۰% تولیدشده توسط هوش مصنوعی را رد کرده است.
مفهوم "استفاده منصفانه" در عصر هوش مصنوعی
مفهوم «استفاده منصفانه» (Fair Use) در قانون کپیرایت، در این زمینه مورد بحث و جدال است. برخی دادگاهها حکم دادهاند که استفاده از مواد دارای حق کپیرایت برای آموزش LLMها میتواند مصداق استفاده منصفانه باشد، به شرطی که مدل خروجی جدید و تحولآفرین تولید کند و جایگزین مستقیم اثر اصلی نشود. با این حال، نحوه دستیابی به دادههای آموزشی نیز اهمیت دارد. دستیابی به محتوای دارای کپیرایت از طریق منابع غیرقانونی (مانند «کتابخانههای سایه» یا LibGen) حتی اگر استفاده از آن برای آموزش مدل «منصفانه» تلقی شود، میتواند منجر به مسئولیت نقض کپیرایت شود.
نگرانیهای حریم خصوصی
علاوه بر مالکیت فکری، نگرانیهای مربوط به حریم خصوصی نیز مطرح است. ابزارهای هوش مصنوعی به دلیل اتکا به دادههای وسیع جمعآوریشده از اینترنت، اغلب بدون شفافیت، مسائل مربوط به حریم خصوصی را ایجاد میکنند. این دادهها میتوانند شامل اطلاعات شخصی، مکالمات خصوصی و دادههای حساس باشند که بدون رضایت صریح افراد جمعآوری و پردازش میشوند.
حفظ کتابهای چاپی در عصر هوش مصنوعی: ارزشی فراتر از داده
با وجود تاکید بر مجموعههای دیجیتال، کتابهای فیزیکی همچنان از اهمیت بالایی برخوردارند. آنها نه تنها اطلاعات را منتقل میکنند، بلکه دارای ارزش زیباییشناختی، تاریخی و اصالت هستند. نسخههای فیزیکی به عنوان مرجعی معتبر برای راستیآزمایی نسخههای دیجیتال عمل میکنند و اتصال ملموسی به ریشهها و تاریخ یک اثر فراهم میآورند. کتابخانهها و آرشیوها همچنان درگیر حفظ مجموعههای فیزیکی هستند، هرچند که دیجیتالیسازی گسترده، تمرکز برخی فعالیتهای حفاظتی را تغییر داده است.
نگرانی از نابودی کتابهای کمیاب و منحصر به فرد در فرآیند اسکن تخریبی، اهمیت حفظ آگاهانه و دقیق این میراث را دوچندان میکند. این کتابها تنها مجموعهای از کلمات نیستند؛ آنها حامل فرهنگ، هنر، تاریخ و هویت یک ملت هستند. از دست دادن آنها، به معنای از دست دادن بخشی غیرقابل بازگشت از حافظه جمعی بشریت است.
مخاطرات گستردهتر هوش مصنوعی: نگاهی جامع
فراتر از مسائل مربوط به داده و مالکیت فکری، هوش مصنوعی خطرات گستردهتری را نیز به همراه دارد که نیازمند توجه و برنامهریزی دقیق است:
- اتوماسیون مشاغل: هوش مصنوعی میتواند منجر به از دست رفتن شغل برای انسانها شود و نابرابری اقتصادی و اجتماعی را افزایش دهد. این امر مستلزم بازنگری در سیستمهای آموزشی و ایجاد فرصتهای شغلی جدید است.
- نقض حریم خصوصی: جمعآوری و استفاده گسترده از دادهها توسط سیستمهای هوش مصنوعی میتواند حریم خصوصی افراد را به شدت تحت تأثیر قرار دهد و نیاز به مقررات سختگیرانهتر برای حفاظت از دادهها را ایجاد میکند.
- تقویت سوگیری و تبعیض: اگر دادههای آموزشی حاوی سوگیری باشند، هوش مصنوعی میتواند این تعصبات را تقویت کرده و تصمیمات تبعیضآمیز بگیرد، به خصوص در حوزههای حساس مانند استخدام، اعطای وام و عدالت کیفری.
- عدم شفافیت (مشکل جعبه سیاه): بسیاری از مدلهای هوش مصنوعی، به ویژه در یادگیری عمیق، دارای ساختارهای پیچیدهای هستند که تفسیر روند تصمیمگیری آنها دشوار است و این عدم شفافیت میتواند مشکلات اخلاقی و مسئولیتپذیری ایجاد کند.
- گسترش اطلاعات نادرست (Deepfake و اخبار جعلی): هوش مصنوعی میتواند محتوای جعلی و گمراهکننده تولید کند که به چالش جدی برای اعتبار اطلاعات و راستیآزمایی تبدیل شده است. این پدیده میتواند به بیثباتی اجتماعی و سیاسی منجر شود.
راهکارهای عملی و توصیهها: مسیری به سوی آیندهای مسئولانه
برای مدیریت چالشهای پیش روی هوش مصنوعی و حفظ میراث فرهنگی، اتخاذ رویکردهای مسئولانه و چندجانبه ضروری است:
- ضرورت دادههای "پاک": تاکید بر استفاده از دادههای آموزشی با کیفیت، اصیل و غیرآلوده به محتوای تولیدی خود هوش مصنوعی، برای جلوگیری از "آلودگی داده" و تضمین عملکرد صحیح مدلها.
- حفظ میراث فیزیکی: سرمایهگذاری در فناوریهای اسکن غیرتخریبی و ایجاد آرشیوهای دیجیتال پایدار و قابل دسترس، همراه با حفظ نسخههای فیزیکی کتابها به عنوان مرجع و میراث فرهنگی.
- بازنگری در قوانین مالکیت فکری: نظامهای حقوقی در سراسر جهان باید به سرعت خود را با چالشهای جدید هوش مصنوعی در زمینه مالکیت فکری و حق کپیرایت تطبیق دهند و تعادل بین نوآوری و حقوق پدیدآورندگان را برقرار کنند.
- توسعه اخلاقی هوش مصنوعی: باید بر توسعه مسئولانه و اخلاقی هوش مصنوعی تاکید شود که شامل شفافیت در جمعآوری داده، کاهش سوگیری، احترام به حقوق پدیدآورندگان و ایجاد مکانیزمهای پاسخگویی باشد.
- آموزش و آگاهیبخشی: افزایش آگاهی عمومی در مورد پیامدها و مخاطرات هوش مصنوعی، و آموزش مهارتهای سواد رسانهای برای تشخیص محتوای تولیدی هوش مصنوعی.
- همکاری بینالمللی: ایجاد چارچوبها و استانداردهای بینالمللی برای توسعه و استفاده از هوش مصنوعی، با هدف جلوگیری از رقابت مخرب و تضمین رعایت اصول اخلاقی.
جمعبندی: تعادل میان پیشرفت و مسئولیت
نابودی کتاب برای آموزش هوش مصنوعی پدیدهای است که در تقاطع پیشرفت تکنولوژیک و حفظ میراث فرهنگی قرار دارد. در حالی که هوش مصنوعی پتانسیل عظیمی برای دگرگونی مثبت جهان دارد، نباید این پیشرفت به بهای نابودی دانش و فرهنگ مکتوب بشری حاصل شود. قحطی داده هوش مصنوعی واقعیتی است که شرکتها را به سمت منابع اصیل سوق میدهد، اما نحوه دستیابی به این منابع باید اخلاقی، قانونی و مسئولانه باشد. حفظ کتابهای چاپی، بازنگری در قوانین مالکیت فکری و توسعه هوش مصنوعی با در نظر گرفتن پیامدهای اخلاقی و اجتماعی، گامهای حیاتی برای تضمین آیندهای هستند که در آن فناوری و انسانیت بتوانند در کنار هم شکوفا شوند. انتخاب با ماست که چگونه این تعادل ظریف را برقرار کنیم و از نابودی میراث گرانبهای خود جلوگیری نماییم.
سؤالات متداول
چرا شرکتهای هوش مصنوعی کتابهای چاپی را برای آموزش مدلهای خود از بین میبرند؟
شرکتهای هوش مصنوعی به دلیل مواجهه با «قحطی داده» با کیفیت بالا، به کتابهای چاپی روی آوردهاند. این کتابها حاوی محتوای اصیل و انسانی هستند که هنوز توسط هوش مصنوعی تولید نشده و برای آموزش مدلهای زبان بزرگ (LLMs) و کاهش سوگیری آنها حیاتی است. روش «اسکن تخریبی» برای سرعت بخشیدن به فرآیند دیجیتالیسازی و کاهش هزینهها به کار میرود که متأسفانه منجر به نابودی فیزیکی کتابها میشود.
«اسکن تخریبی» چیست و چه پیامدهایی دارد؟
«اسکن تخریبی» روشی است که در آن شیرازه کتابها با دستگاههای برش هیدرولیک جدا شده و صفحات آنها به صورت مجزا وارد اسکنرهای صنعتی پرسرعت میشوند تا محتوای آنها دیجیتالی شود. پیامد اصلی این روش، نابودی کامل و فیزیکی میلیونها جلد کتاب است که میتواند منجر به از بین رفتن دائمی نسخههای کمیاب و تخصصی و در نتیجه، بخشی از میراث فرهنگی و دانش بشری شود.
آیا استفاده از کتابهای دارای حق کپیرایت برای آموزش هوش مصنوعی قانونی است؟
این موضوع در حوزه حقوقی «استفاده منصفانه» (Fair Use) بحثبرانگیز است. برخی دادگاهها ممکن است استفاده از مواد دارای کپیرایت برای آموزش LLMها را منصفانه تلقی کنند، به شرطی که خروجی مدل جدید و تحولآفرین باشد و جایگزین مستقیم اثر اصلی نشود. با این حال، دستیابی به این محتوا از طریق منابع غیرقانونی (مانند کتابخانههای سایه) میتواند منجر به مسئولیت نقض کپیرایت شود و مسائل حقوقی پیچیدهای را به وجود آورد.
چگونه میتوانیم کتابهای چاپی را در عصر هوش مصنوعی حفظ کنیم؟
برای حفظ کتابهای چاپی، باید بر سرمایهگذاری در فناوریهای اسکن غیرتخریبی تاکید شود که امکان دیجیتالیسازی را بدون آسیب رساندن به نسخههای فیزیکی فراهم میکند. همچنین، ایجاد آرشیوهای دیجیتال پایدار و قابل دسترس، همراه با حفظ دقیق نسخههای فیزیکی در کتابخانهها و آرشیوها به عنوان مرجع و میراث فرهنگی، ضروری است. افزایش آگاهی عمومی و بازنگری در قوانین مالکیت فکری نیز به این امر کمک میکند.
چه مخاطرات اخلاقی گستردهتری در مورد توسعه هوش مصنوعی وجود دارد؟
علاوه بر مسائل مربوط به نابودی کتابها و مالکیت فکری، هوش مصنوعی مخاطرات گستردهتری مانند اتوماسیون مشاغل و افزایش نابرابری، نقض حریم خصوصی به دلیل جمعآوری وسیع دادهها، تقویت سوگیریها و تبعیضهای موجود در دادههای آموزشی، عدم شفافیت در فرآیندهای تصمیمگیری (مشکل جعبه سیاه) و گسترش اطلاعات نادرست (مانند دیپفیک و اخبار جعلی) را به همراه دارد.

حسین موذن خوش الحان
من حسین مؤذن خوشالحان، طراح و توسعهدهنده وب هستم و تمرکزم روی ساخت وبسایتهای سریع، حرفهای، سئوشده و کاربرپسند است. در پروژههایم از ابزارهای هوش مصنوعی مانند ChatGPT، Claude، Codex و Bolt.new برای تحلیل بهتر، توسعه سریعتر، تولید محتوا، خودکارسازی فرایندها و حل مسائل پیچیده استفاده میکنم. ترکیب تجربه فنی، طراحی دقیق و ابزارهای هوش مصنوعی به من کمک میکند ایدهها را به محصولات دیجیتال کاربردی و قابل توسعه تبدیل کنم. از طراحی سایتهای اختصاصی و وردپرسی تا توسعه افزونه، بهینهسازی سرعت و پیادهسازی سیستمهای هوشمند، هدفم ارائه راهکاری تمیز، قابل اعتماد و نتیجهمحور برای هر پروژه است.



اولین دیدگاه را بنویس
تجربه، سؤال یا نظر مرتبطت را با احترام بنویس.